
A Huawei apresentou o cronograma dos aceleradores Ascend 960DT, 960PR, 970 e 980 durante o Huawei Connect 2026. Os planos também incluem sistemas Atlas para inteligência artificial.
A empresa antecipou a chegada da família Ascend 960 para atender à demanda crescente do setor. Os próximos chips terão mudanças na arquitetura, na capacidade de processamento e na memória.
Ascend 960 chega em duas versões em 2027
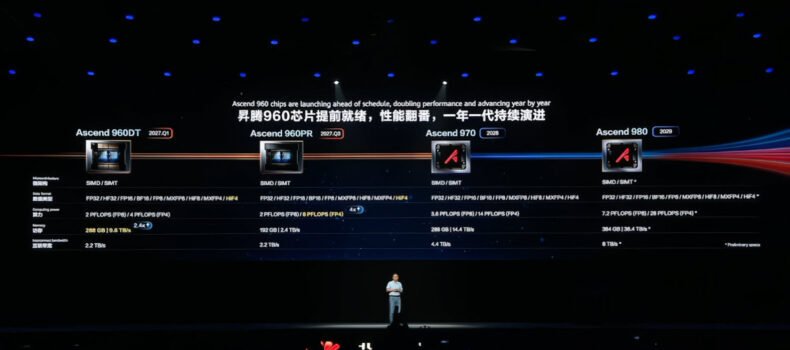
O Ascend 960DT será o sucessor do Ascend 950. Seu lançamento está previsto para o primeiro trimestre de 2027, três trimestres antes do planejamento anterior.
O chip usará uma nova arquitetura SIMD/SIMT, com suporte aos formatos FP32, HF32, FP16, BF16, FP8, MXFP8, HiF8, MXFP4 e HiF4, usados nos cálculos de IA.
- Leia também: Filha caçula de fundador da Huawei aparece em Pequim e contraria parte dos rumores de fuga da família
Os formatos H consideram tanto a precisão quanto o intervalo de valores representáveis. Com isso, um único formato pode substituir dois formatos convencionais de ponto flutuante.
A capacidade de processamento será de até 2 PFLOPS em FP8 e 4 PFLOPS em FP4. O Ascend 960DT terá 288 GB de memória HBM, com largura de banda de 9,6 TB/s.
Essa taxa de transferência de memória corresponde a 2,4 vezes a da série Ascend 950. Já a largura de banda de interconexão será de 2,2 TB/s.
O Ascend 960PR chegará no terceiro trimestre de 2027, um trimestre antes do plano anterior. Essa versão terá maior desempenho em inferência, etapa em que a IA usa um modelo já treinado.
O processamento em FP4 passará para 8 PFLOPS, enquanto o desempenho em FP8 será de 2 PFLOPS. A memória será menor: 192 GB de HBM, com largura de banda de 2,4 TB/s. A interconexão manterá os mesmos 2,2 TB/s do Ascend 960DT.
Ascend 970 e 980 ampliam processamento e memória
Para 2028, a Huawei planeja o Ascend 970, com outra mudança de arquitetura. Os números apresentados são de até 3,6 PFLOPS em FP8 e 14 PFLOPS em FP4.
A capacidade de memória continuará em 288 GB de HBM, mas a largura de banda subirá para 14,4 TB/s. Essa taxa sugere um padrão de memória posterior ao HBM3/HBM3E.
A largura de banda de interconexão também dobrará, chegando a 4,4 TB/s. O Ascend 980 aparece no cronograma para 2029, ainda com especificações preliminares.
Há também uma indicação de 2028 para esse chip, o que deixa uma divergência nas datas divulgadas. A proposta é dar continuidade à arquitetura dos modelos anteriores, com 7,2 PFLOPS em FP8 e 28 PFLOPS em FP4.
O chip terá 384 GB de HBM, com largura de banda de 38,4 TB/s, além de interconexão de 8 TB/s. Segundo a Huawei, essas especificações podem mudar até o lançamento.
| Chip | Lançamento previsto | Processamento informado | Memória e largura de banda | Interconexão |
|---|---|---|---|---|
| Ascend 960DT | 1º trimestre de 2027, antecipado em três trimestres | 2 PFLOPS em FP8 / 4 PFLOPS em FP4 | 288 GB de HBM a 9,6 TB/s | 2,2 TB/s |
| Ascend 960PR | 3º trimestre de 2027, antecipado em um trimestre | 2 PFLOPS em FP8 / 8 PFLOPS em FP4 | 192 GB de HBM a 2,4 TB/s | 2,2 TB/s |
| Ascend 970 | 2028 | 3,6 PFLOPS em FP8 / 14 PFLOPS em FP4, conforme os slides | 288 GB de HBM a 14,4 TB/s | 4,4 TB/s |
| Ascend 980 | 2029, com previsão preliminar | 7,2 PFLOPS em FP8 / 28 PFLOPS em FP4 | 384 GB de HBM a 38,4 TB/s | 8 TB/s |
Atlas 960E reúne 4.096 processadores de IA
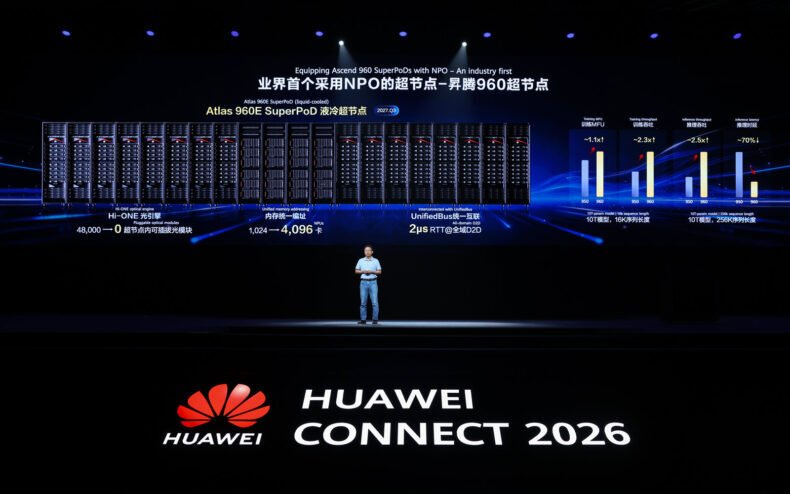
A Huawei também anunciou o Atlas 960E SuperPoD, previsto para o terceiro trimestre de 2027. O sistema terá refrigeração líquida e 4.096 NPUs, processadores dedicados à IA.
Segundo a empresa, será o primeiro SuperPoD do setor com NPO, tecnologia que posiciona componentes ópticos perto do encapsulamento dos chips.
A comunicação usará o módulo óptico Hi-ONE, com taxa de transmissão de 7,2 Tb/s por unidade. O desempenho previsto é de 8 EFLOPS em FP8 e 16 EFLOPS em FP4.
As NPUs terão endereçamento unificado de memória. A conexão será feita pelo UnifiedBus, com tempo de ida e volta de 2 microssegundos na comunicação entre chips em todo o sistema.
Cerca de 5.500 módulos Hi-ONE substituirão dezenas de milhares de módulos de conexão 800G. A redução no consumo será superior a 550 kW, com disponibilidade declarada de 99,8%.
Os números de memória incluem cerca de 1 PB de HBM em algumas apresentações oficiais e um conjunto de 256 TB de memória unificada. As contagens variam conforme a memória considerada, entre a HBM junto aos chips e a estrutura de memória do SuperPoD.
Em comparação com o Atlas 950, o Atlas 960E terá até 2,3 vezes a capacidade de processamento no treinamento de um modelo com 10 trilhões de parâmetros e sequências de 16 mil tokens.
Na inferência, a taxa será até 2,5 vezes maior para um modelo de 10 trilhões de parâmetros com contexto de 256 mil tokens. A latência, ou tempo de resposta, será 70% menor.
Vários Atlas 960E poderão ser conectados por RoCE ou Lingqu. Esses agrupamentos terão até 512 mil aceleradores, ou até 1 milhão em uma topologia com múltiplos caminhos de conexão.
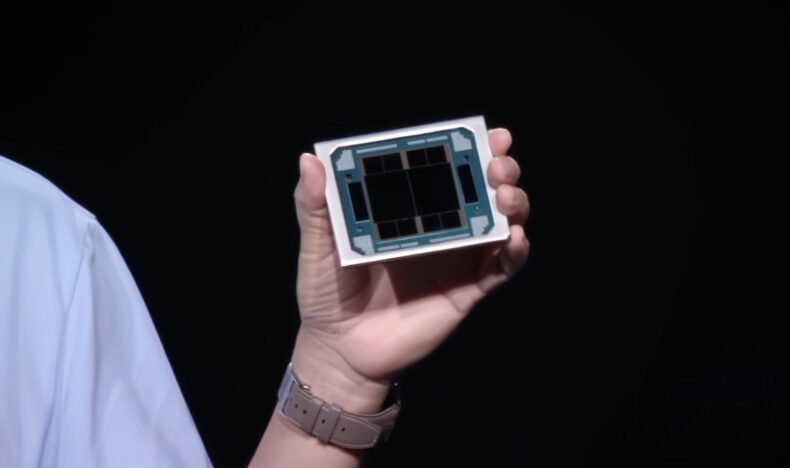
OceanStor M900 expande o cache da IA para SSDs
A Huawei também apresentou o OceanStor M900, uma solução de memória e armazenamento para lidar com a demanda crescente por cache KV.
Esse cache guarda dados usados pela IA durante o processamento do contexto. Com o OceanStor M900, ele passa a ocupar também SSDs, além da memória de vídeo e da memória principal.
A rede Lingqu conectará uma estrutura global de cache em vários níveis, com capacidade na escala de petabytes e acesso direto em um único salto de comunicação.
Um único agrupamento poderá ter 64 PB de capacidade. O cache disponível por NPU passará da escala de gigabytes para terabytes.
Isso dá espaço para guardar, compartilhar e reutilizar mais contexto, com uma melhora expressiva na frequência com que os dados necessários já estão no cache.
O OceanStor M900 combina CPU, rede e controlador de discos. Assim, a NPU acessa o SSD diretamente, sem conversão de protocolos nem encaminhamento pela CPU.
Segundo os números divulgados, a latência de acesso cairá da escala de milissegundos para 60 microssegundos, com redução declarada de 90%.
A largura de banda agregada de acesso será de 40 TB/s por agrupamento. A Huawei informa que esse desempenho é 1,5 vez superior aos padrões do setor.
Os planos indicam uma estratégia que vai além de um único chip. A família Ascend 960 foi antecipada, com os modelos 970 e 980 na sequência anual prevista.
O Atlas 960E concentra essa estratégia ao combinar conexões ópticas, milhares de NPUs e memória compartilhada.
Se o cronograma for cumprido, a Huawei buscará ganhos em IA com sistemas mais rápidos e agrupamentos maiores, além do desempenho de cada chip.