
Uma falha no Windows presente desde julho de 2026 esteve entre as causas da queda global do Microsoft 365 nos dias 12 e 13 de novembro.
O problema afetou Outlook, Teams, Copilot e outros serviços. O aumento do tráfego e a capacidade reduzida da infraestrutura também contribuíram para a interrupção.
O relatório preliminar da Microsoft, datado de 15 de novembro, registra o início da falha às 13h20 do dia 12 e o fim às 13h10 do dia 13, no horário de Brasília. Foram quase 24 horas de problemas. O Exchange Online foi o serviço mais afetado.
Muitos usuários ficaram sem acesso às caixas de entrada ou tiveram dificuldades para enviar e receber emails. Teams, Copilot, SharePoint e OneDrive também apresentaram falhas em funções que dependem do Exchange Online.
Como uma falha de julho causou a queda do Microsoft 365
A investigação preliminar identificou três fatores. O primeiro foi um defeito introduzido por uma atualização do Windows instalada em julho de 2026 nos servidores que recebem e encaminham as conexões do Microsoft 365.
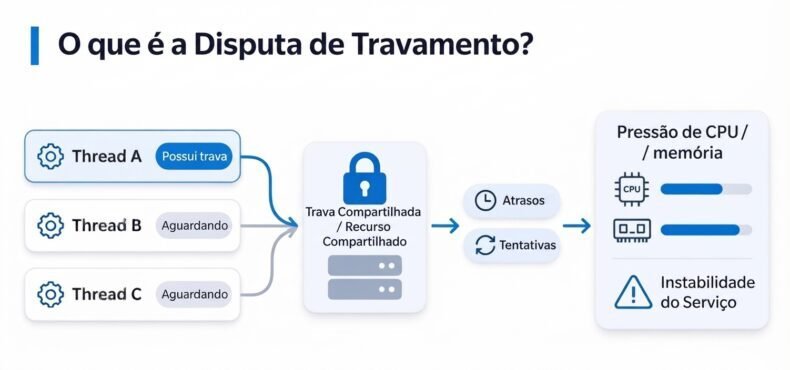
Em certas condições de uso, tarefas de um processo interno do Windows disputavam o acesso aos mesmos recursos. Isso esgotava a capacidade do processador e da memória, até que os servidores paravam de responder.
O defeito ficou mais de três meses sem causar problemas e passou pelos testes da Microsoft. Os laboratórios usavam principalmente máquinas menos potentes, com processadores de menos núcleos, nas quais a falha tinha menos chance de aparecer.
O segundo fator foi uma mudança no tráfego do Teams. Cerca de 15 horas antes da interrupção, as conexões do aplicativo foram transferidas automaticamente de uma estrutura alternativa para a principal, compartilhada com o Exchange Online.
Esse tipo de troca faz parte da operação normal, mas aumentou a carga sobre os servidores afetados. Além disso, cerca de 14% da capacidade dos servidores dessa estrutura já estava indisponível por causa de outro problema ocorrido no dia anterior.
À medida que as máquinas paravam de responder, os sistemas automáticos transferiam as solicitações para os servidores que ainda funcionavam. Essas máquinas também ficavam sobrecarregadas e deixavam de responder.
Em duas horas, mais de 80% dos servidores responsáveis por essas conexões estavam sem resposta. Os mecanismos criados para limitar as falhas a cada região não impediram que o problema se espalhasse pelo mundo.
O defeito era específico da infraestrutura de conexão do Microsoft 365. Outras instalações do Windows não foram afetadas por essa falha.
Correção e retomada dos serviços
A recuperação demorou porque os servidores voltavam a travar após serem reiniciados e receberem as solicitações acumuladas.
Os mecanismos usados para desfazer alterações também não resolveram o problema, pois a atualização com defeito havia sido instalada meses antes.
A equipe de engenharia desenvolveu e aplicou uma correção que devolveu o código responsável pelas conexões ao estado anterior, quando funcionava normalmente. A infraestrutura voltou a operar aos poucos em 13 de novembro.
Às 11h17, no horário de Brasília, o acesso ao email pelo navegador já havia retornado aos níveis normais em todo o mundo. A interrupção geral terminou às 13h10, seguida por um período de acompanhamento.
A Microsoft confirmou a recuperação na conta oficial Microsoft 365 Status, no X. As últimas notificações sobre o estado dos serviços foram publicadas em 14 de novembro.
Microsoft amplia capacidade e controle do tráfego
Após a falha, a Microsoft adicionou controles à distribuição das conexões, ampliou o monitoramento da infraestrutura e aumentou a capacidade dos servidores.
Durante a interrupção, também estendeu o prazo para as tentativas de entrega de emails, para preservar as mensagens que aguardavam envio. Depois, confirmou o processamento dos emails acumulados.
O incidente teve origem técnica, sem indícios de atividade maliciosa ou participação de agentes de inteligência artificial.
A investigação continuou após a análise preliminar. O relatório final, datado de 20 de novembro de 2026, reúne outras medidas para evitar interrupções semelhantes.
Comentários
Participe da discussão Compartilhe sua opinião ou tire uma dúvida.